KI-Crawler — sperren, erlauben oder unterscheiden?
„Blockier einfach alle KI-Bots“ war vor zwei Jahren ein verbreiteter Rat und ist heute schädlich. Der Grund ist eine Unterscheidung, die viele nicht kennen: Training und Antwort sind unterschiedliche Programme mit unterschiedlichen Namen.
Es gibt mindestens drei Arten von Abrufen: für das Training von Modellen, für Antworten mit Quellenangabe, und für Abrufe im Auftrag eines Nutzers. Sie haben unterschiedliche Namen — auch beim selben Anbieter. Wer pauschal alles sperrt, schließt sich aus Antworten aus, in denen er genannt würde. Und zu llms.txt gibt es eine unbequeme Nachricht: Sie wird von den Systemen praktisch nicht abgerufen.
Website down oder gehackt? Schreib mir per WhatsApp oder E-Mail mit Domain und kurzer Beschreibung — ich melde mich in der Regel innerhalb weniger Stunden, auch am Wochenende, wenn es brennt. Zugangsdaten bitte nie in der ersten Nachricht, sondern erst nach Absprache über einen sicheren Weg.
Die drei Arten.
| Art | Zweck | Nutzen für dich | Empfehlung |
|---|---|---|---|
| Trainingsabruf | Inhalte für das Modelltraining | Keiner, mittelbar Bekanntheit | Eigene Entscheidung |
| Antwortabruf | Inhalte für Antworten mit Quelle | Erwähnung und Verweise | Erlauben |
| Nutzerabruf | Ein Nutzer lässt eine Seite ansehen | Wie ein Besucher | Erlauben |
Diese Unterscheidung ist der Kern des Themas. Der Trainingsabruf nimmt Inhalte auf, ohne dass du etwas davon hast — außer dass Modelle dein Thema besser kennen. Der Antwortabruf ist das Gegenteil: Er holt Inhalte, um sie in einer Antwort zu nennen, mit Verweis auf dich.
Der Nutzerabruf entsteht, wenn jemand eine Adresse in ein Antwortsystem gibt und fragt, was dort steht. Das ist faktisch ein Besucher und sollte nie gesperrt werden (KI-Sichtbarkeit).
Die Namen kennen.
Jeder Anbieter benennt seine Programme unterschiedlich, und beim selben Anbieter heißen Training und Antwort anders. Eine Regel, die das eine sperrt, sperrt das andere nicht — und umgekehrt.
Praktisch heißt das: Du musst die aktuellen Namen kennen, und sie ändern sich. Die Anbieter veröffentlichen sie in ihren Hilfebereichen; dort steht auch, welches Programm welchem Zweck dient.
Mein Rat: Nicht aus einem Blogartikel abschreiben, sondern einmal selbst in den Protokollen nachsehen, wer tatsächlich kommt, und dann gezielt entscheiden. Eine aus dem Netz kopierte Liste ist nach sechs Monaten veraltet (Protokolle auswerten).
Warum pauschal schadet.
Der verbreitete Rat „sperr alles, was nach KI aussieht“ stammt aus einer Zeit, in der es nur Trainingsabrufe gab. Inzwischen beantworten dieselben Systeme Fragen mit Quellenangaben — und wer gesperrt ist, kommt dort nicht vor.
Das ist dieselbe Entscheidung wie bei einer Suchmaschine: Man kann sich sperren, verliert damit aber die Sichtbarkeit. Für ein Unternehmen, das über seine Website Anfragen bekommt, ist das in aller Regel die falsche Richtung.
Eine andere Lage haben Anbieter, deren Produkt der Inhalt selbst ist — Verlage, Datenbanken, Nachschlagewerke. Dort kann es sinnvoll sein, Trainingsabrufe zu sperren und über Lizenzen zu verhandeln. Für den Mittelstand gilt das praktisch nie.
Steuern über robots.txt.
Das etablierte Mittel. Für jedes Programm ein eigener Regelblock mit dem Namen und den Regeln darunter (robots.txt).
Zwei Dinge, die dabei falsch gemacht werden. Erstens: Ein Programm liest nur den Block, der es namentlich nennt — und ignoriert dann den allgemeinen Block vollständig. Wer für alle etwas sperrt und zusätzlich einen Block für einen bestimmten Bot schreibt, muss die allgemeinen Regeln dort wiederholen.
Zweitens: Die Datei ist eine Bitte. Seriöse Anbieter halten sich daran, andere nicht. Wer wirklich verhindern will, dass Inhalte abgerufen werden, braucht eine technische Sperre.
llms.txt — der ehrliche Stand.
Ein vorgeschlagenes Format: eine Datei im Hauptverzeichnis, die die wichtigsten Inhalte einer Website in aufbereiteter Form auflistet, damit Sprachmodelle sie leichter erfassen können. Die Idee ist nachvollziehbar und wird viel beworben.
Der Stand nach allem, was sich derzeit nachvollziehen lässt: Die Datei liegt auf etwa jeder zehnten Domain, und die großen Abrufprogramme holen sie praktisch nie ab — Auswertungen großer Bot-Zugriffsmengen zeigen nur verschwindend wenige Abrufe auf diesen Pfad. Die Systeme lesen stattdessen das HTML.
Daraus folgt: Es ist keine Wundermaßnahme, und wer dafür Geld verlangt, verkauft eine Hoffnung. Es ist auch nicht schädlich — die Datei kostet nichts und könnte an Bedeutung gewinnen, wenn sich das Format durchsetzt.
Meine Haltung: Wenn du eine saubere Übersicht deiner wichtigsten Inhalte ohnehin pflegst, leg sie an. Wenn es Aufwand bedeutet, steck die Zeit in die Inhalte selbst. Und nimm sie niemandem als Argument ab, der dir ein Paket verkaufen will. Dieser Abschnitt hat einen Faktenstand — prüf ihn nach, wenn du in einem Jahr darauf stößt.
Rechtliche Einordnung.
Ich bin kein Rechtsanwalt, deshalb nur das Grobe: Im europäischen Urheberrecht gibt es eine Schranke für die automatisierte Auswertung von Inhalten, verbunden mit der Möglichkeit, dem zu widersprechen — und dieser Widerspruch muss maschinenlesbar erklärt werden.
Praktisch bedeutet das, dass eine entsprechende Erklärung in der robots.txt oder in den Nutzungsbedingungen rechtliche Bedeutung haben kann. Ob und wie das durchsetzbar ist, ist Gegenstand laufender Auseinandersetzungen.
Wenn das für dich wichtig ist — weil deine Inhalte dein Produkt sind — kläre es anwaltlich. Für die meisten Unternehmen ist es eine theoretische Frage, und die praktische lautet: Will ich in Antworten vorkommen oder nicht?
Technisch durchsetzen.
Wenn eine Sperre wirklich wirken soll, reicht die robots.txt nicht. Möglichkeiten, mit steigendem Aufwand:
- Serverregeln, die bestimmte Kennungen abweisen.
- Sperren nach Adressbereich der bekannten Anbieter.
- Dienste vorschalten, die das als Funktion anbieten.
- Zugangsschutz für wirklich schützenswerte Inhalte.
Zum letzten Punkt der ehrliche Hinweis: Alles, was öffentlich abrufbar ist, kann kopiert werden. Wenn Inhalte wirklich nicht in fremde Hände sollen, gehören sie hinter eine Anmeldung — alles andere ist eine Hürde, keine Mauer.
Serverlast.
Ein praktischer Aspekt neben der Grundsatzfrage: Manche Abrufprogramme erzeugen erhebliche Last, besonders auf großen Websites. Wenn in den Protokollen ein Bot auffällt, der häufiger abruft als alle Suchmaschinen zusammen, ist das ein Betriebsthema.
Lösungen: Abrufrate begrenzen, wo der Anbieter das unterstützt; Bereiche sperren, die ohnehin nicht relevant sind; oder im Extremfall ganz sperren. Das ist dann keine inhaltliche, sondern eine technische Entscheidung (Serverlast).
Entscheidungshilfe.
| Lage | Empfehlung |
|---|---|
| Unternehmen, lebt von Anfragen | Antwortabrufe erlauben, Training nach Haltung |
| Shop | Alles erlauben, Sichtbarkeit zählt |
| Verlag, Inhalte sind das Produkt | Training sperren, Antworten abwägen |
| Fachdatenbank hinter Anmeldung | Öffentlicher Teil erlauben, Rest geschützt |
| Website erzeugt hohe Last | Begrenzen statt sperren |
| Unsicher | Erlauben, beobachten, später entscheiden |
Die letzte Zeile ist ernst gemeint. Sperren lässt sich jederzeit nachholen; verlorene Sichtbarkeit zurückzuholen dauert. Wer unsicher ist, fährt mit Erlauben und Beobachten besser.
Prüfen, wer kommt.
- Protokolle der letzten Wochen besorgen.
- Nach Bot-Kennungen auswerten und zählen.
- Zuordnen: Training, Antwort oder Nutzerabruf?
- Last bewerten — wie viele Abrufe, welche Bereiche?
- Entscheiden und in der robots.txt umsetzen.
- Nach vier Wochen prüfen, ob die Regeln greifen.
- Halbjährlich nachsehen, weil neue Programme dazukommen.
Punkt sieben ist wichtig: Das Feld verändert sich schnell. Eine Konfiguration von heute kennt die Programme von übermorgen nicht — und eine Regel, die einen alten Namen sperrt, läuft ins Leere, während das Nachfolgeprogramm ungehindert abruft.
Wenn du nicht weiterkommst.
Wenn du entscheiden willst, wen du hereinlässt, und wissen musst, wer tatsächlich kommt. Ich prüfe, was tatsächlich im Weg steht, und behebe es: technisches SEO. Geht es um Tempo, hängt das mit dran (Core Web Vitals). Damit es so bleibt, gehört die regelmäßige Kontrolle in die laufende Betreuung.
Ursache finden, Website wieder zum Laufen bringen, kurzer Bericht — meist am selben Tag.
Für Anpassungen, Fehlerbehebung und Beratung nach Aufwand, abgerechnet in 15-Minuten-Schritten.
Updates, Backups, Sicherheitscheck, Monitoring — Kleinigkeiten inklusive.
Orientierungswerte, keine Fixpreise — nach einem kurzen Gespräch bekommst du ein Festpreisangebot.
Wer hilft.
Ich bin Manuel Killert, Webentwickler aus Quakenbrück. Technisches SEO ist bei mir kein Marketingangebot, sondern die Fortsetzung der Entwicklungsarbeit: ordentliche Adressen, saubere Weiterleitungen, korrekte Auszeichnungen, erreichbare Inhalte. Das sind Dinge, die man im Quelltext prüft und behebt — nicht in einem Konzept beschreibt.
Was ich nicht mache: Inhaltsstrategie, Keyword-Recherche als Dauerleistung, Linkaufbau oder monatliche Berichte mit grünen Pfeilen. Dafür gibt es Leute, die das besser können. Wenn dein Problem heißt „wir brauchen mehr Themen“, bist du bei einer SEO-Agentur richtig; wenn es heißt „unsere Seiten sind nicht im Index“, bei mir.
Und ich verspreche keine Platzierungen. Wer dir Platz eins garantiert, weiß entweder nicht, wovon er redet, oder meint ein Keyword, nach dem niemand sucht.
Echte Projekte — live ansehen.
WordPress-Websites, die ich gebaut habe oder laufend betreue.
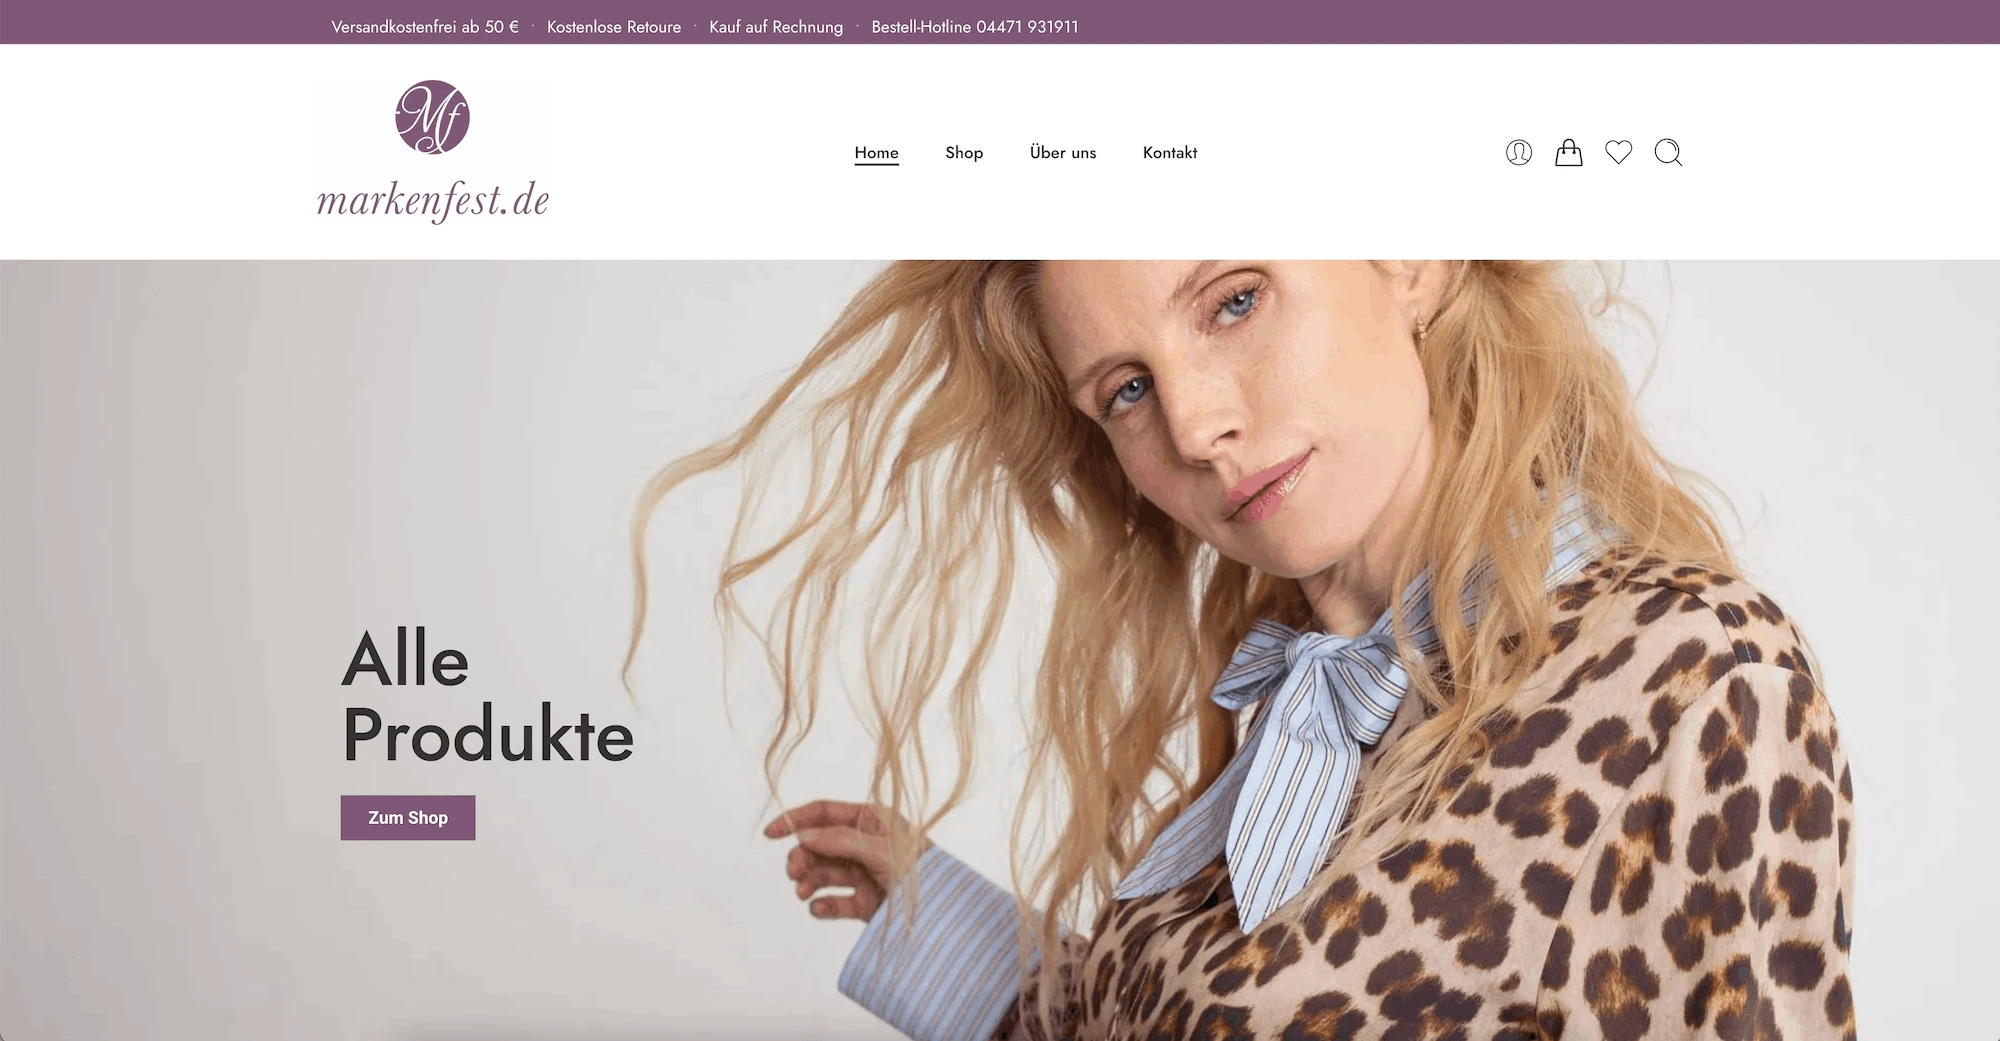
Markenfest
Stärkerer Online-Shop — Webdesign, Content und individuelle Shop-Funktionen.
Website ansehen ↗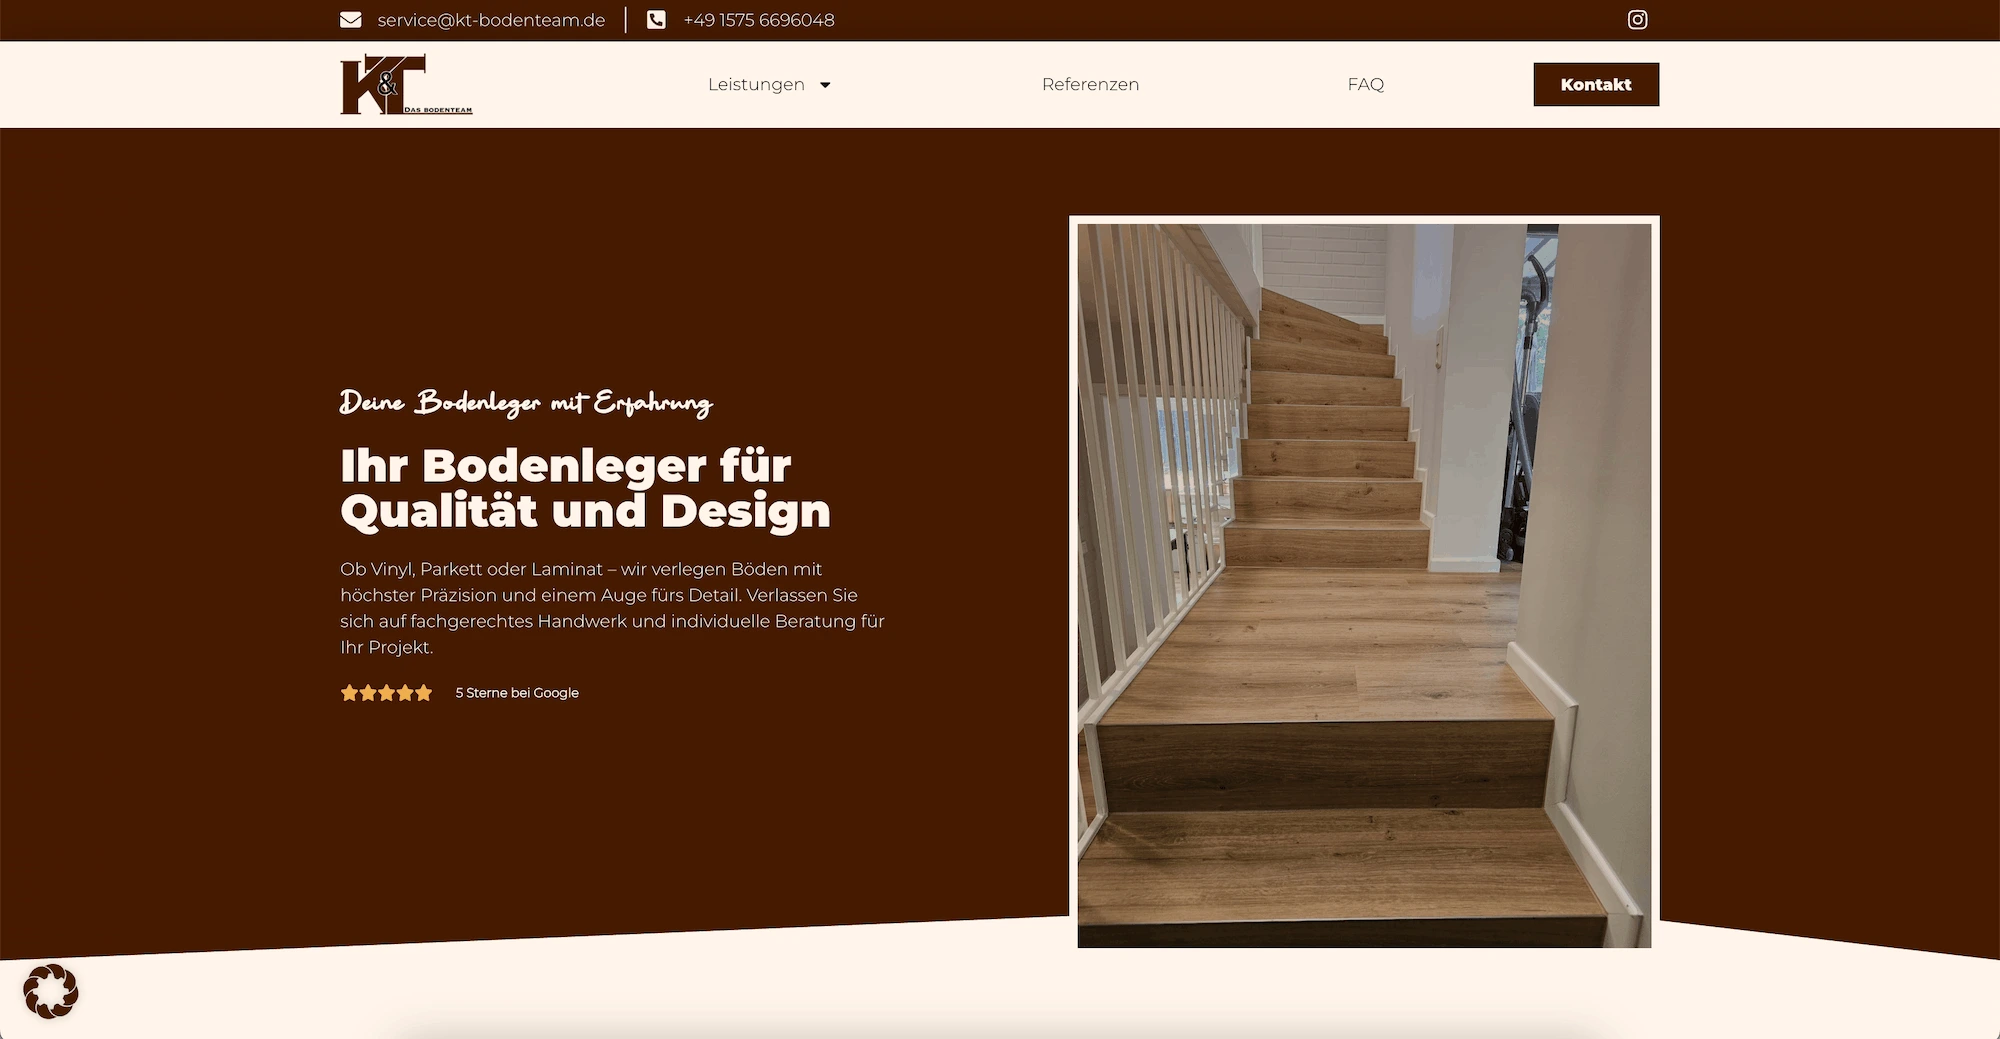
KT Bodenteam
Professioneller Auftritt für einen Bodenleger — Vorher-Nachher-Slider und regionale SEO.
Website ansehen ↗
Potassco Solutions
Klare Website für ein KI-Unternehmen, die komplexe Technologie verständlich macht.
Website ansehen ↗FAQ — KI-Crawler steuern.
Soll ich KI-Crawler blockieren?
Nicht pauschal. Trainingsabrufe, Antwortabrufe und Abrufe im Auftrag eines Nutzers sind unterschiedliche Programme. Wer alles sperrt, schließt sich aus Antworten aus, in denen er genannt würde.
Was ist der Unterschied zwischen Training und Antwort?
Der Trainingsabruf nimmt Inhalte für das Modelltraining auf, ohne dass du etwas davon hast. Der Antwortabruf holt Inhalte, um sie in einer Antwort mit Verweis auf dich zu nennen.
Bringt eine llms.txt etwas?
Nach aktuellem Stand kaum. Sie liegt auf etwa jeder zehnten Domain und wird von den großen Abrufprogrammen praktisch nie abgerufen — sie lesen stattdessen das HTML. Schaden tut sie nicht, aber wer dafür Geld verlangt, verkauft eine Hoffnung.
Reicht die robots.txt als Sperre?
Sie ist eine Bitte, keine technische Sperre. Seriöse Anbieter halten sich daran, andere nicht. Für eine wirksame Sperre braucht es Serverregeln oder einen vorgeschalteten Dienst.
Was mache ich, wenn ein Bot zu viel Last erzeugt?
Das ist eine technische, keine inhaltliche Frage. Abrufrate begrenzen wo möglich, irrelevante Bereiche sperren, im Extremfall ganz sperren.
Wie oft muss ich die Einstellungen prüfen?
Etwa halbjährlich. Es kommen neue Programme dazu und Namen ändern sich — eine Regel, die einen alten Namen sperrt, läuft ins Leere, während das Nachfolgeprogramm ungehindert abruft.
 Das bin ich – rechts im Bild
Erzähl mir, welche Seiten nicht gefunden werden.
Schick mir die Adresse und was dir auffällt — Seiten verschwinden aus dem Index, Besucher brechen weg, oder du weißt nach einem Relaunch nicht, was kaputtgegangen ist. Ich sehe nach, woran es liegt.
Antwort meist innerhalb von 24 Stunden · hallo@manuelkillert.de