robots.txt — eine Zeile kann alles abschalten.
Die kleinste Datei auf dem Server mit der größten Hebelwirkung. Sie wird oft falsch verstanden: Sie steuert, was abgerufen werden darf — nicht, was im Index landet. Dieser Unterschied ist die Quelle fast aller Fehler.
Die Datei steuert den Abruf, nicht die Indexierung. Eine gesperrte Seite kann trotzdem im Index stehen — und eine gesperrte Seite mit noindex bleibt drin, weil das noindex nie gelesen wird. Sperre deshalb nur, was gar nicht abgerufen werden soll, und nutze für „soll nicht in den Index“ das noindex. Und sperre niemals CSS- und JavaScript-Dateien.
Website down oder gehackt? Schreib mir per WhatsApp oder E-Mail mit Domain und kurzer Beschreibung — ich melde mich in der Regel innerhalb weniger Stunden, auch am Wochenende, wenn es brennt. Zugangsdaten bitte nie in der ersten Nachricht, sondern erst nach Absprache über einen sicheren Weg.
Was die Datei macht.
Sie liegt im Hauptverzeichnis und wird von Suchmaschinen vor dem Abruf gelesen. Darin steht, welche Bereiche welche Programme abrufen dürfen. Das ist eine Bitte, keine technische Sperre — seriöse Anbieter halten sich daran, andere nicht.
Wer etwas wirklich schützen will, braucht einen Zugangsschutz. Die robots.txt ist dafür ungeeignet; sie ist öffentlich lesbar und verrät damit sogar, wo etwas liegt, das nicht gefunden werden soll.
Das große Missverständnis.
Sperren heißt nicht Entfernen. Eine gesperrte Seite wird nicht abgerufen — sie kann aber trotzdem im Index landen, wenn andere Seiten darauf verlinken. In den Ergebnissen erscheint sie dann ohne Beschreibung, mit einem Hinweis, dass keine Informationen verfügbar sind.
Noch wichtiger ist die Umkehrung: Wer eine Seite aus dem Index entfernen will und sie dafür sperrt, erreicht das Gegenteil. Die Suchmaschine darf die Seite nicht mehr abrufen, sieht das noindex nicht und lässt sie im Index — womöglich für lange Zeit.
Die Regel lautet deshalb: Soll nicht abgerufen werden → robots.txt. Soll nicht im Index stehen → noindex, und die Seite abrufbar lassen (Indexierung).
Aufbau.
| Angabe | Bedeutung |
|---|---|
| User-agent | Für welches Programm die folgenden Regeln gelten |
| Disallow | Dieser Pfad darf nicht abgerufen werden |
| Allow | Ausnahme innerhalb eines gesperrten Bereichs |
| Sitemap | Wo die Sitemap liegt |
| Leerzeile | Trennt Regelblöcke voneinander |
Zwei Dinge, die oft falsch gemacht werden. Erstens gilt ein Regelblock nur für den darüber genannten Empfänger; wer Regeln für alle und zusätzlich für einen bestimmten Bot schreibt, muss wissen, dass der bestimmte Bot nur seinen eigenen Block liest und den allgemeinen ignoriert. Zweitens trennt die Leerzeile die Blöcke — eine vergessene Leerzeile führt dazu, dass Regeln dem falschen Empfänger zugeordnet werden.
Sinnvoll für WordPress.
Die meisten Websites brauchen fast nichts. Sinnvoll ist in der Regel:
- Den Verwaltungsbereich sperren, mit einer Ausnahme für die Datei, über die der Blockeditor arbeitet.
- Interne Suchergebnisse sperren, weil sie beliebig viele Adressen erzeugen.
- Filterkombinationen sperren, wenn sie in die Tausende gehen.
- Sitemap eintragen.
Mehr ist selten nötig. Lange robots.txt-Dateien mit dreißig Regeln sind fast immer aus Blogartikeln zusammenkopiert und enthalten Sperren, die schaden (Interne Suche).
Was nicht gesperrt gehört.
- CSS- und JavaScript-Dateien. Suchmaschinen bauen die Seite nach, um sie zu bewerten. Fehlen die Dateien, sehen sie eine kaputte Seite.
- Bilder, wenn sie in der Bildersuche erscheinen sollen.
- Das Upload-Verzeichnis, aus demselben Grund.
- Seiten, die aus dem Index sollen — dafür noindex.
- Die gesamte Website, außer sie soll wirklich unsichtbar sein.
Der erste Punkt war früher verbreitet und ist heute schädlich. Eine Website, deren Gestaltungsdateien gesperrt sind, wird als unbrauchbar auf dem Handy eingestuft — mit entsprechender Wirkung.
Sitemap eintragen.
Eine Zeile mit der vollständigen Adresse der Sitemap. Das ist der einfachste Weg, sie bekannt zu machen, und wirkt für alle Suchmaschinen gleichzeitig — nicht nur für die, bei der man ein Konto hat.
Bei mehreren Sitemaps trägt man die Übersichtsdatei ein, nicht jede einzelne (Sitemap).
KI-Crawler.
Seit einigen Jahren rufen zusätzlich Programme von KI-Anbietern Websites ab. Dabei ist eine Unterscheidung entscheidend, die oft übersehen wird:
| Art | Wofür | Sperren? |
|---|---|---|
| Trainingsabruf | Inhalte für das Training von Modellen | Deine Entscheidung |
| Antwortabruf | Inhalte für Antworten mit Quellenangabe | Eher nicht sperren |
| Nutzerabruf | Ein Nutzer lässt eine Seite ansehen | Nicht sperren |
Diese drei sind unterschiedliche Programme mit unterschiedlichen Namen — auch beim selben Anbieter. Wer pauschal alles sperrt, was nach KI aussieht, sperrt damit auch den Abruf, über den Antworten mit Verweis auf die eigene Seite entstehen. Das ist der häufigste Fehler in diesem Bereich und schadet der Sichtbarkeit.
Meine Empfehlung für die meisten Unternehmen: Antwortabrufe erlauben, Trainingsabrufe nach eigener Haltung entscheiden. Wer von Sichtbarkeit lebt, hat wenig Grund, sich aus Antworten herauszuhalten (KI-Crawler steuern).
Testen.
- Datei aufrufen und lesen — sie muss im Hauptverzeichnis liegen.
- Antwortstatus prüfen: Sie muss „in Ordnung“ melden, nicht umleiten.
- Prüfwerkzeug der Search Console für einzelne Adressen nutzen.
- Eine echte Seite testen, nicht nur die Startseite.
- Eine CSS-Datei testen — darf nicht gesperrt sein.
- Nach jeder Änderung erneut prüfen.
Punkt zwei wird übersehen und ist tückisch: Wenn die Datei nicht existiert und der Server stattdessen die Fehlerseite mit Status „in Ordnung“ ausliefert, lesen Suchmaschinen HTML statt Regeln. Das Ergebnis ist unvorhersehbar.
Die teuersten Fehler.
- Sperre für alles aus der Entwicklungsphase nicht entfernt — der mit Abstand teuerste.
- Der WordPress-Schalter zur Suchmaschinensichtbarkeit ist aktiv.
- CSS und JavaScript gesperrt.
- Seiten gesperrt, die eigentlich auf noindex sollten.
- Alle KI-Abrufe gesperrt, auch die für Antworten.
- Datei liegt im falschen Verzeichnis und wird nie gelesen.
- Nach einem Relaunch die alte Datei übernommen, mit alten Pfaden.
Punkt eins und zwei gehören auf jede Startcheckliste. Setz dir eine Erinnerung auf den Tag nach jedem Livegang, das kostet eine Minute und erspart Wochen (Nach dem Relaunch).
Etwas aus dem Index bekommen.
Der richtige Weg, in dieser Reihenfolge:
- Sperre in der robots.txt entfernen, falls vorhanden.
- noindex setzen auf der Seite.
- Warten, bis die Seite erneut abgerufen wurde.
- Bei Dringlichkeit die Entfernung über die Search Console beantragen — das wirkt vorübergehend.
- Erst danach sperren, wenn die Seite aus dem Index verschwunden ist und auch nicht mehr abgerufen werden soll.
Diese Reihenfolge umzudrehen ist der Klassiker: erst sperren, dann wundern, warum die Seite monatelang in den Ergebnissen bleibt.
Wenn du nicht weiterkommst.
Wenn du unsicher bist, ob deine robots.txt hilft oder schadet. Ich prüfe, was tatsächlich im Weg steht, und behebe es: technisches SEO. Geht es um Tempo, hängt das mit dran (Core Web Vitals). Damit es so bleibt, gehört die regelmäßige Kontrolle in die laufende Betreuung.
Ursache finden, Website wieder zum Laufen bringen, kurzer Bericht — meist am selben Tag.
Für Anpassungen, Fehlerbehebung und Beratung nach Aufwand, abgerechnet in 15-Minuten-Schritten.
Updates, Backups, Sicherheitscheck, Monitoring — Kleinigkeiten inklusive.
Orientierungswerte, keine Fixpreise — nach einem kurzen Gespräch bekommst du ein Festpreisangebot.
Wer hilft.
Ich bin Manuel Killert, Webentwickler aus Quakenbrück. Technisches SEO ist bei mir kein Marketingangebot, sondern die Fortsetzung der Entwicklungsarbeit: ordentliche Adressen, saubere Weiterleitungen, korrekte Auszeichnungen, erreichbare Inhalte. Das sind Dinge, die man im Quelltext prüft und behebt — nicht in einem Konzept beschreibt.
Was ich nicht mache: Inhaltsstrategie, Keyword-Recherche als Dauerleistung, Linkaufbau oder monatliche Berichte mit grünen Pfeilen. Dafür gibt es Leute, die das besser können. Wenn dein Problem heißt „wir brauchen mehr Themen“, bist du bei einer SEO-Agentur richtig; wenn es heißt „unsere Seiten sind nicht im Index“, bei mir.
Und ich verspreche keine Platzierungen. Wer dir Platz eins garantiert, weiß entweder nicht, wovon er redet, oder meint ein Keyword, nach dem niemand sucht.
Echte Projekte — live ansehen.
WordPress-Websites, die ich gebaut habe oder laufend betreue.
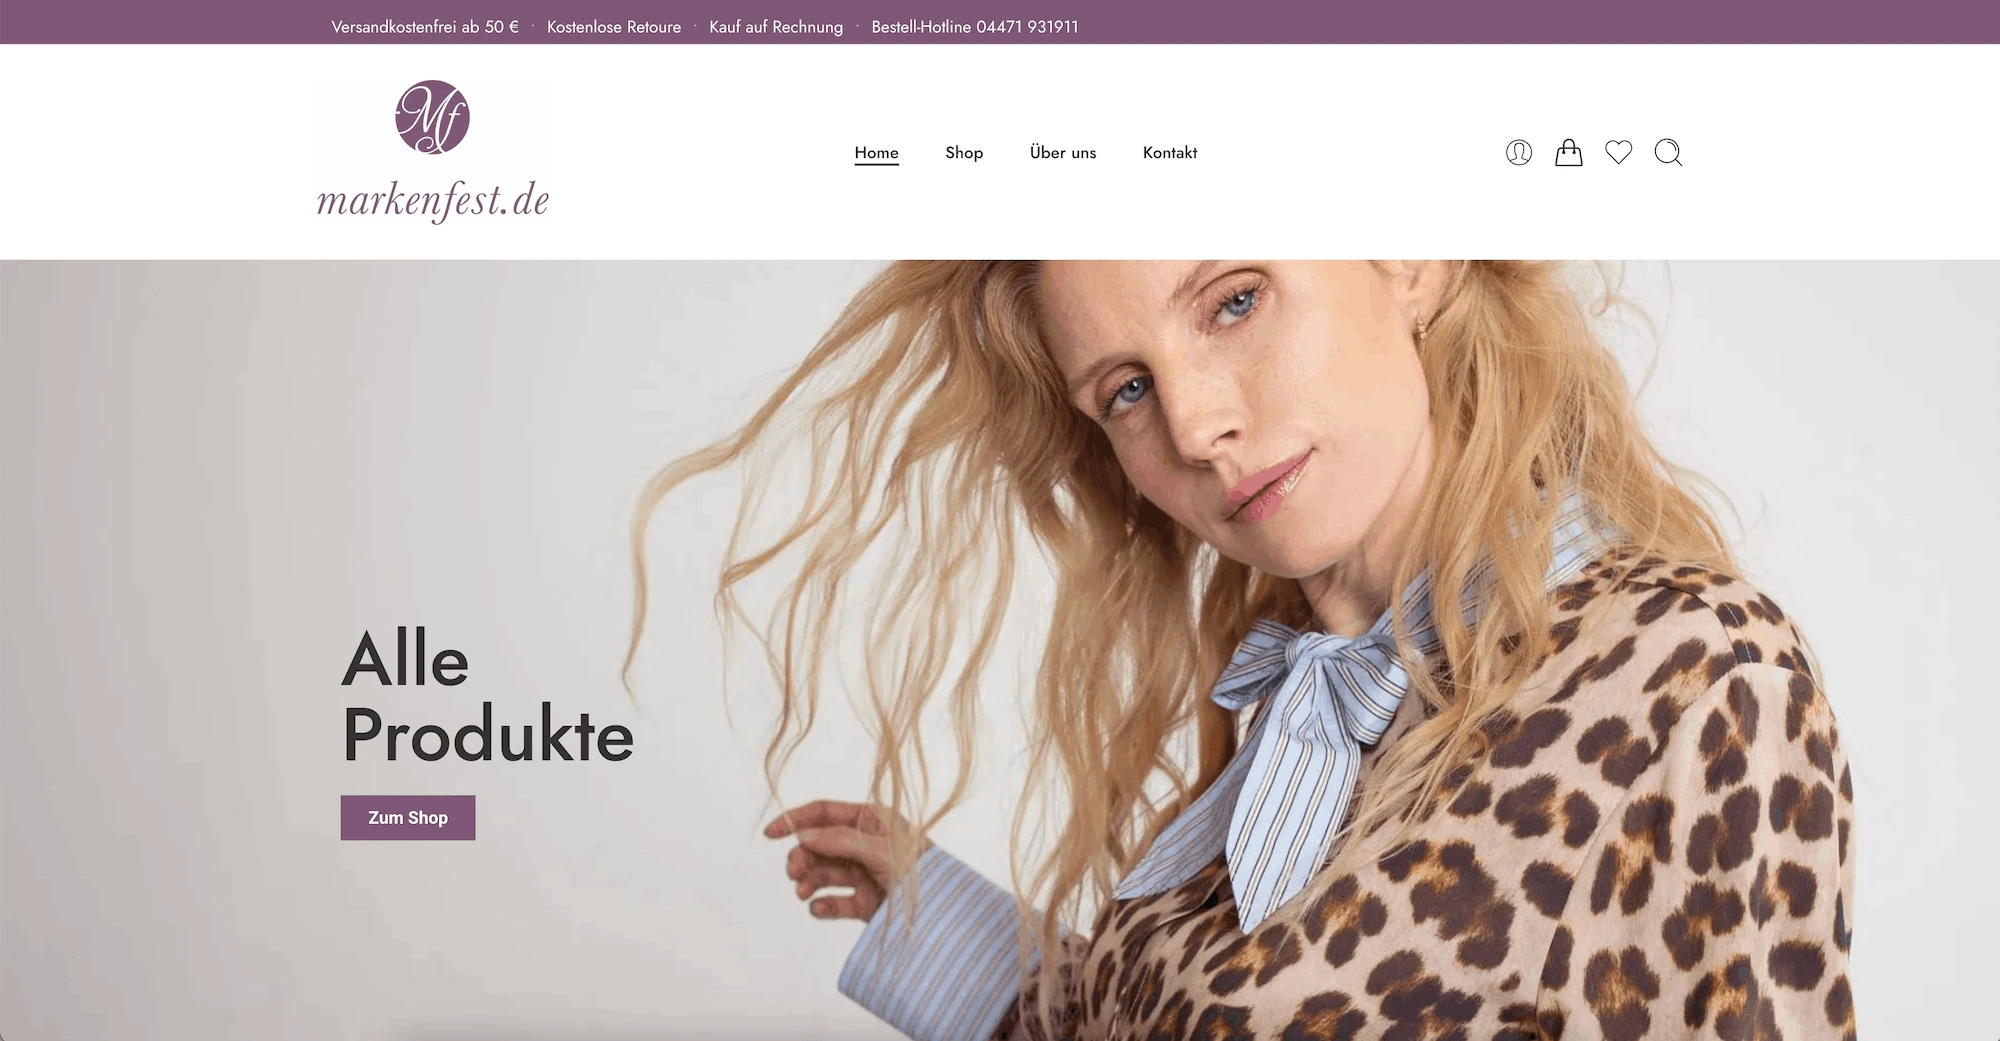
Markenfest
Stärkerer Online-Shop — Webdesign, Content und individuelle Shop-Funktionen.
Website ansehen ↗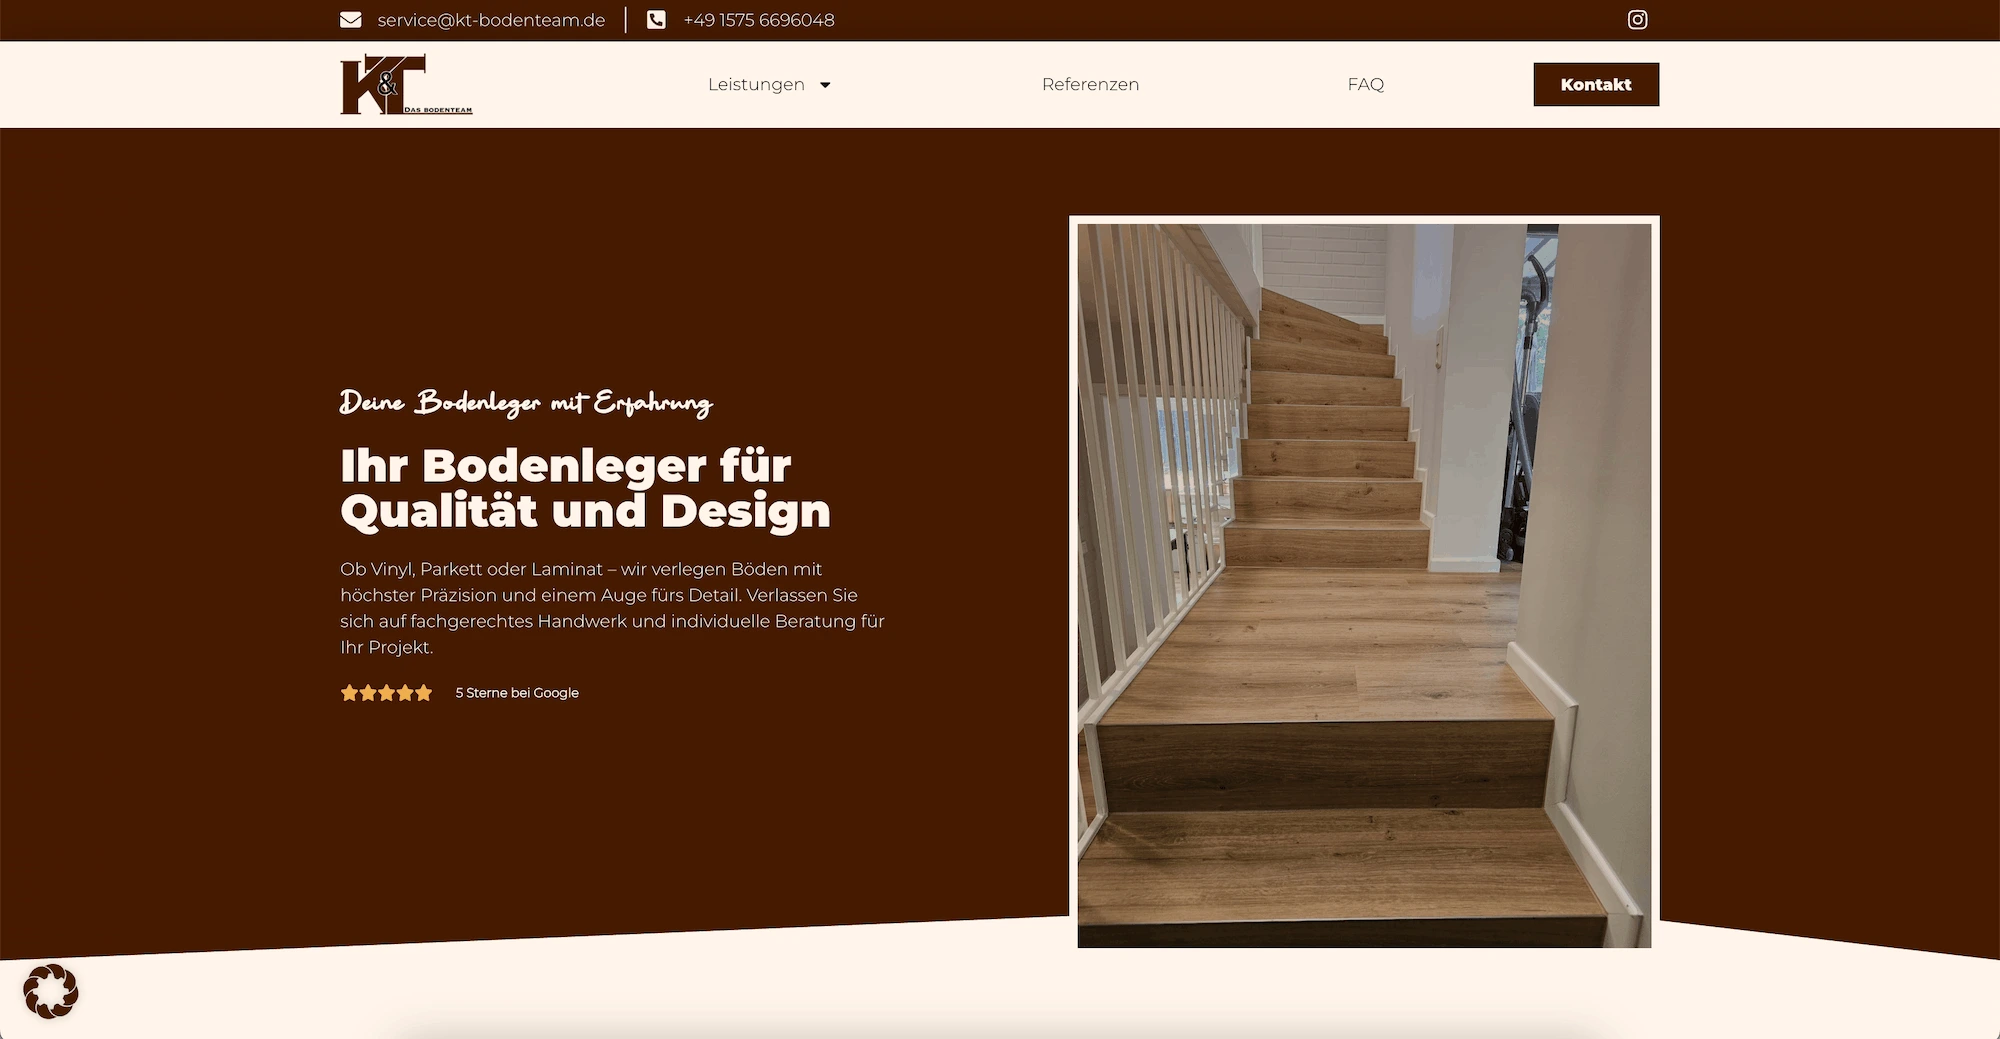
KT Bodenteam
Professioneller Auftritt für einen Bodenleger — Vorher-Nachher-Slider und regionale SEO.
Website ansehen ↗
Potassco Solutions
Klare Website für ein KI-Unternehmen, die komplexe Technologie verständlich macht.
Website ansehen ↗FAQ — robots.txt.
Verhindert die robots.txt, dass eine Seite im Index landet?
Nein. Sie steuert nur den Abruf. Eine gesperrte Seite kann trotzdem im Index erscheinen, wenn andere darauf verlinken — dann ohne Beschreibung.
Wie bekomme ich eine Seite aus dem Index?
Mit noindex, und die Seite muss dafür abrufbar bleiben. Wer sie stattdessen sperrt, erreicht das Gegenteil: Die Suchmaschine sieht das noindex nie und lässt die Seite drin.
Darf ich CSS und JavaScript sperren?
Nein. Suchmaschinen bauen die Seite nach, um sie zu bewerten. Fehlen diese Dateien, sehen sie eine kaputte Seite — mit entsprechender Wirkung auf die Bewertung.
Was gehört bei WordPress hinein?
Wenig: den Verwaltungsbereich sperren mit Ausnahme der Datei für den Blockeditor, interne Suchergebnisse sperren, bei Bedarf ausufernde Filterkombinationen, und die Sitemap eintragen.
Soll ich KI-Crawler sperren?
Nicht pauschal. Trainingsabrufe und Antwortabrufe sind unterschiedliche Programme mit unterschiedlichen Namen. Wer alles sperrt, sperrt auch den Abruf, über den Antworten mit Verweis auf die eigene Seite entstehen.
Was ist der teuerste Fehler?
Die Sperre für alles aus der Entwicklungsphase nach dem Livegang nicht zu entfernen — oder in WordPress den Schalter zur Suchmaschinensichtbarkeit aktiv zu lassen.
 Das bin ich – rechts im Bild
Erzähl mir, welche Seiten nicht gefunden werden.
Schick mir die Adresse und was dir auffällt — Seiten verschwinden aus dem Index, Besucher brechen weg, oder du weißt nach einem Relaunch nicht, was kaputtgegangen ist. Ich sehe nach, woran es liegt.
Antwort meist innerhalb von 24 Stunden · hallo@manuelkillert.de