Nicht im Index — und meistens aus einem von sechs Gründen.
Eine Seite, die nicht im Index ist, kann nicht gefunden werden. Die Ursache steht fast immer in der Search Console — man muss nur wissen, was die Meldungen bedeuten, denn die Formulierungen sind alles andere als selbsterklärend.
Trenne zuerst zwei Dinge: Crawling ist, ob die Seite abgerufen wird — Indexierung ist, ob sie aufgenommen wird. Beides kann einzeln scheitern. Die häufigsten Ursachen: eine Sperre in der robots.txt, ein noindex, ein Canonical auf eine andere Seite, eine Weiterleitung, fehlende interne Verlinkung — oder die Seite ist schlicht zu dünn.
Website down oder gehackt? Schreib mir per WhatsApp oder E-Mail mit Domain und kurzer Beschreibung — ich melde mich in der Regel innerhalb weniger Stunden, auch am Wochenende, wenn es brennt. Zugangsdaten bitte nie in der ersten Nachricht, sondern erst nach Absprache über einen sicheren Weg.
Crawling und Indexierung.
Zwei getrennte Vorgänge, die ständig verwechselt werden. Beim Crawling ruft die Suchmaschine die Seite ab. Bei der Indexierung entscheidet sie, ob die Seite in den Suchindex aufgenommen wird.
Daraus folgen vier mögliche Zustände: nicht gecrawlt und nicht indexiert; gecrawlt, aber nicht indexiert; indexiert, obwohl nicht gecrawlt — das gibt es, wenn eine gesperrte Seite oft verlinkt wird; und der Normalfall, gecrawlt und indexiert.
Der zweite Zustand ist der häufigste Problemfall und der unangenehmste: Technisch ist alles in Ordnung, die Suchmaschine will die Seite nur nicht haben. Dagegen hilft keine Einstellung (Nicht bei Google).
Die Meldungen im Klartext.
| Meldung sinngemäß | Was wirklich gemeint ist | Handeln? |
|---|---|---|
| Durch robots.txt blockiert | Abruf gesperrt | Ja, Sperre prüfen |
| Mit noindex ausgeschlossen | Ausdrücklich ausgeschlossen | Ja, falls ungewollt |
| Alternative Seite mit Canonical | Verweist auf eine andere Seite | Prüfen, oft richtig |
| Seite mit Weiterleitung | Leitet weiter | Meist richtig |
| Gefunden, zurzeit nicht indexiert | Bekannt, noch nicht abgerufen | Abwarten, verlinken |
| Gecrawlt, zurzeit nicht indexiert | Abgerufen, nicht aufgenommen | Qualitätsfrage |
| Duplikat ohne Canonical | Doppelter Inhalt erkannt | Ja, Canonical setzen |
| Soft 404 | Sieht aus wie eine Fehlerseite | Ja, Inhalt oder Status prüfen |
Die wichtigste Unterscheidung steckt in Zeile fünf und sechs. „Gefunden“ heißt: Die Adresse ist bekannt, aber noch nicht abgerufen — das ist Geduld oder ein Hinweis auf zu viele unwichtige Seiten. „Gecrawlt“ heißt: abgerufen und bewusst nicht aufgenommen — das ist ein Urteil über den Inhalt.
Gesperrt in robots.txt.
Der einfachste Fall und der mit der größten Wirkung. Eine Zeile sperrt im Zweifel die ganze Website. Prüf sie zuerst, es dauert zehn Sekunden: Adresse aufrufen und lesen, was dort steht.
Typische Ursachen: Die Sperre aus der Entwicklungsphase wurde nach dem Start nicht entfernt, in WordPress ist der Schalter zur Suchmaschinensichtbarkeit aktiv, oder ein Plugin hat etwas ergänzt. Der WordPress-Schalter ist der häufigste Einzelfall überhaupt — er sitzt in den Leseeinstellungen und wird beim Aufsetzen gern gesetzt und nie wieder angefasst (robots.txt richtig einrichten).
Auf noindex gesetzt.
Eine Angabe im Kopfbereich der Seite oder im Antwortkopf des Servers, die ausdrücklich sagt: nicht aufnehmen. Anders als eine Sperre in der robots.txt wird die Seite dabei abgerufen und dann abgelehnt.
Woher sie kommt: eine Einstellung im SEO-Plugin, oft für einen ganzen Inhaltstyp; eine Vorgabe für Archivseiten oder Blätterseiten; ein Rest aus der Entwicklungsphase; oder eine Regel auf Serverebene.
Wichtig zu wissen: Eine Seite, die gleichzeitig in der robots.txt gesperrt und auf noindex gesetzt ist, bleibt womöglich im Index — weil die Suchmaschine die Seite nicht abrufen darf und das noindex deshalb nie sieht. Wer etwas aus dem Index entfernen will, muss es abrufbar lassen.
Canonical zeigt woanders hin.
Die Angabe, welche Adresse die maßgebliche ist. Zeigt sie auf eine andere Seite, wird diese andere indexiert statt der aufgerufenen.
Das ist oft richtig — etwa bei Filterseiten oder Druckansichten. Problematisch wird es, wenn alle Seiten auf die Startseite zeigen, ein Theme-Fehler eine falsche Adresse setzt, oder die interne Adresse eines abgeschirmten Systems eingetragen ist (Canonical richtig setzen).
Weiterleitung oder Fehler.
Leitet eine Adresse weiter, wird das Ziel indexiert. Das ist gewollt. Problematisch sind Ketten über mehrere Stationen und Schleifen — die brechen ab.
Ebenso zu prüfen: Welchen Status gibt der Server zurück? Eine Seite, die aussieht wie eine Fehlerseite, aber den Status „alles in Ordnung“ meldet, wird als Soft 404 eingestuft und nicht aufgenommen. Das betrifft oft leere Kategorieseiten oder Suchergebnisse ohne Treffer (Weiterleitungen).
Nicht verlinkt.
Eine Seite, die von nirgendwo verlinkt ist, wird selten abgerufen — auch wenn sie in der Sitemap steht. Die Sitemap ist ein Hinweis, keine Garantie.
Prüf deshalb: Ist die Seite aus dem Menü, aus einer Übersicht oder aus einem Beitrag erreichbar? Wie viele Klicks von der Startseite entfernt? Alles jenseits von drei bis vier Klicks wird seltener besucht.
Das ist besonders bei großen Websites relevant. Tausend Seiten, die nur in der Sitemap stehen und sonst nirgends, werden nicht vollständig erfasst (Crawling verstehen).
Erkannt, aber nicht aufgenommen.
Der unangenehme Fall. Die Seite wurde abgerufen und bewusst nicht indexiert. Das ist keine technische Einstellung, sondern ein Urteil: Die Seite bietet aus Sicht der Suchmaschine nicht genug Eigenes.
Typische Auslöser: sehr wenig Text, Inhalte, die anderswo fast identisch stehen, automatisch erzeugte Seiten ohne Mehrwert, Produktseiten mit übernommenen Herstellertexten, Filterkombinationen, Autoren- und Datumsarchive.
Was hilft, ist unspektakulär: weniger Seiten mit mehr Substanz. Lieber hundert gute Seiten als tausend dünne — und die dünnen entweder zusammenführen, ausbauen oder auf noindex setzen (Doppelte Inhalte).
Inhalt nur per JavaScript.
Suchmaschinen verarbeiten JavaScript, aber verzögert und nicht immer vollständig. Inhalte, die erst im Browser nachgeladen werden, kommen womöglich nie an.
Prüfen lässt sich das in zehn Sekunden: Seitenquelltext anzeigen und nach einem Satz aus dem Text suchen. Steht er dort nicht, ist er für die erste Verarbeitung nicht vorhanden. Betroffen sind besonders nachgeladene Produktlisten, Registerkarten und Akkordeons mit nachgeladenem Inhalt (Ausgabe ohne JavaScript).
Der Prüfweg.
- robots.txt aufrufen und lesen.
- In WordPress den Schalter zur Sichtbarkeit prüfen.
- Quelltext der Seite nach noindex und Canonical durchsuchen.
- Serverstatus prüfen — kommt wirklich „in Ordnung“ zurück?
- Search Console, URL-Prüfung für die konkrete Adresse.
- Interne Verlinkung prüfen.
- Quelltext nach einem Textauszug durchsuchen.
- Inhalt ehrlich bewerten: Gibt es hier etwas Eigenes?
Die ersten vier Schritte dauern zusammen fünf Minuten und klären die Mehrzahl der Fälle. Schritt fünf nennt dir den Grund im Klartext — nutz die Funktion, bevor du rätst.
Wie lange es dauert.
Nach einer Korrektur geschieht nichts sofort. Eine einzelne wichtige Seite lässt sich über die Search Console zur erneuten Prüfung anmelden und wird oft in Tagen erfasst. Bei vielen Seiten geht das nicht einzeln — dort hilft nur eine aktualisierte Sitemap und Geduld.
Realistisch sind einige Tage bis mehrere Wochen, bei großen Websites länger. Wer nach drei Tagen nichts sieht und deshalb weitere Änderungen vornimmt, macht die Fehlersuche schwerer. Eine Änderung, dann warten, dann prüfen.
Wenn du nicht weiterkommst.
Wenn Seiten nicht im Index landen und die Search Console Meldungen zeigt, die niemand versteht. Ich prüfe, was tatsächlich im Weg steht, und behebe es: technisches SEO. Geht es um Tempo, hängt das mit dran (Core Web Vitals). Damit es so bleibt, gehört die regelmäßige Kontrolle in die laufende Betreuung.
Ursache finden, Website wieder zum Laufen bringen, kurzer Bericht — meist am selben Tag.
Für Anpassungen, Fehlerbehebung und Beratung nach Aufwand, abgerechnet in 15-Minuten-Schritten.
Updates, Backups, Sicherheitscheck, Monitoring — Kleinigkeiten inklusive.
Orientierungswerte, keine Fixpreise — nach einem kurzen Gespräch bekommst du ein Festpreisangebot.
Wer hilft.
Ich bin Manuel Killert, Webentwickler aus Quakenbrück. Technisches SEO ist bei mir kein Marketingangebot, sondern die Fortsetzung der Entwicklungsarbeit: ordentliche Adressen, saubere Weiterleitungen, korrekte Auszeichnungen, erreichbare Inhalte. Das sind Dinge, die man im Quelltext prüft und behebt — nicht in einem Konzept beschreibt.
Was ich nicht mache: Inhaltsstrategie, Keyword-Recherche als Dauerleistung, Linkaufbau oder monatliche Berichte mit grünen Pfeilen. Dafür gibt es Leute, die das besser können. Wenn dein Problem heißt „wir brauchen mehr Themen“, bist du bei einer SEO-Agentur richtig; wenn es heißt „unsere Seiten sind nicht im Index“, bei mir.
Und ich verspreche keine Platzierungen. Wer dir Platz eins garantiert, weiß entweder nicht, wovon er redet, oder meint ein Keyword, nach dem niemand sucht.
Echte Projekte — live ansehen.
WordPress-Websites, die ich gebaut habe oder laufend betreue.
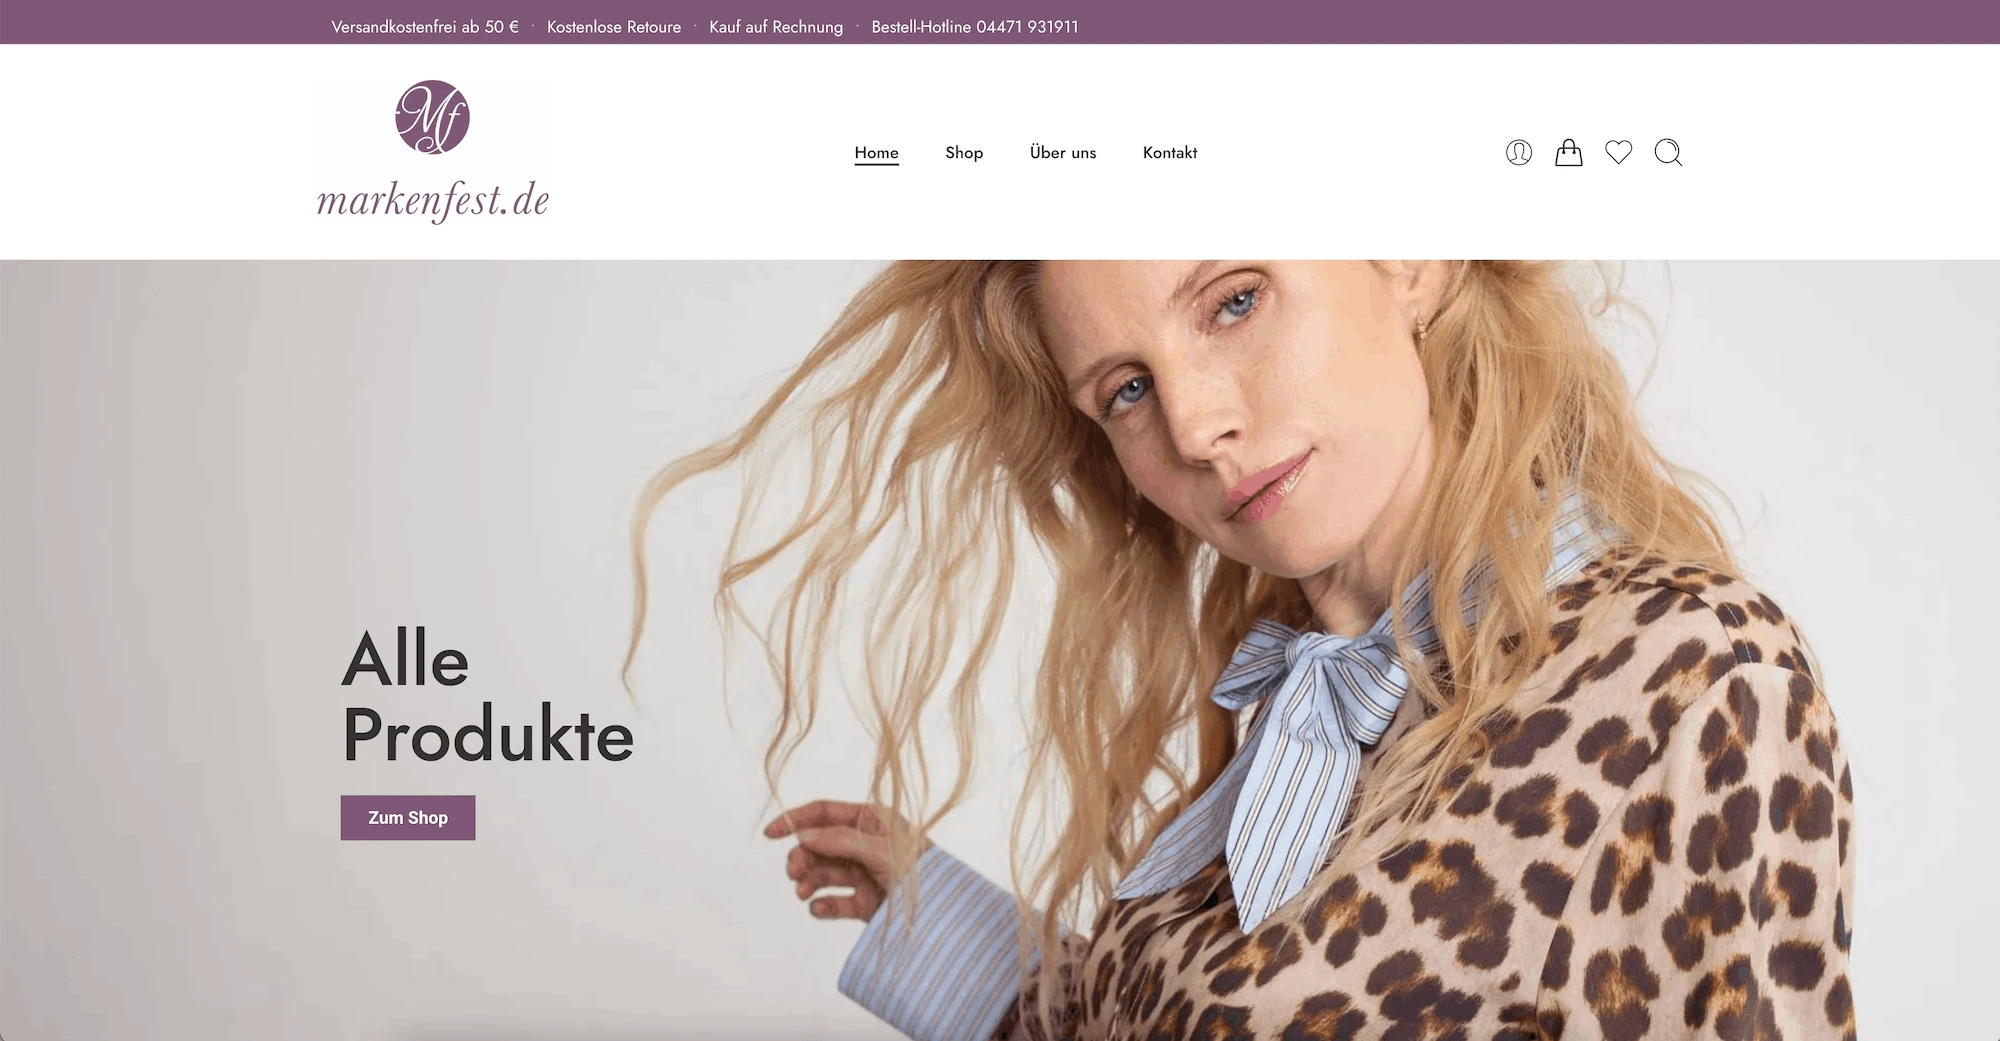
Markenfest
Stärkerer Online-Shop — Webdesign, Content und individuelle Shop-Funktionen.
Website ansehen ↗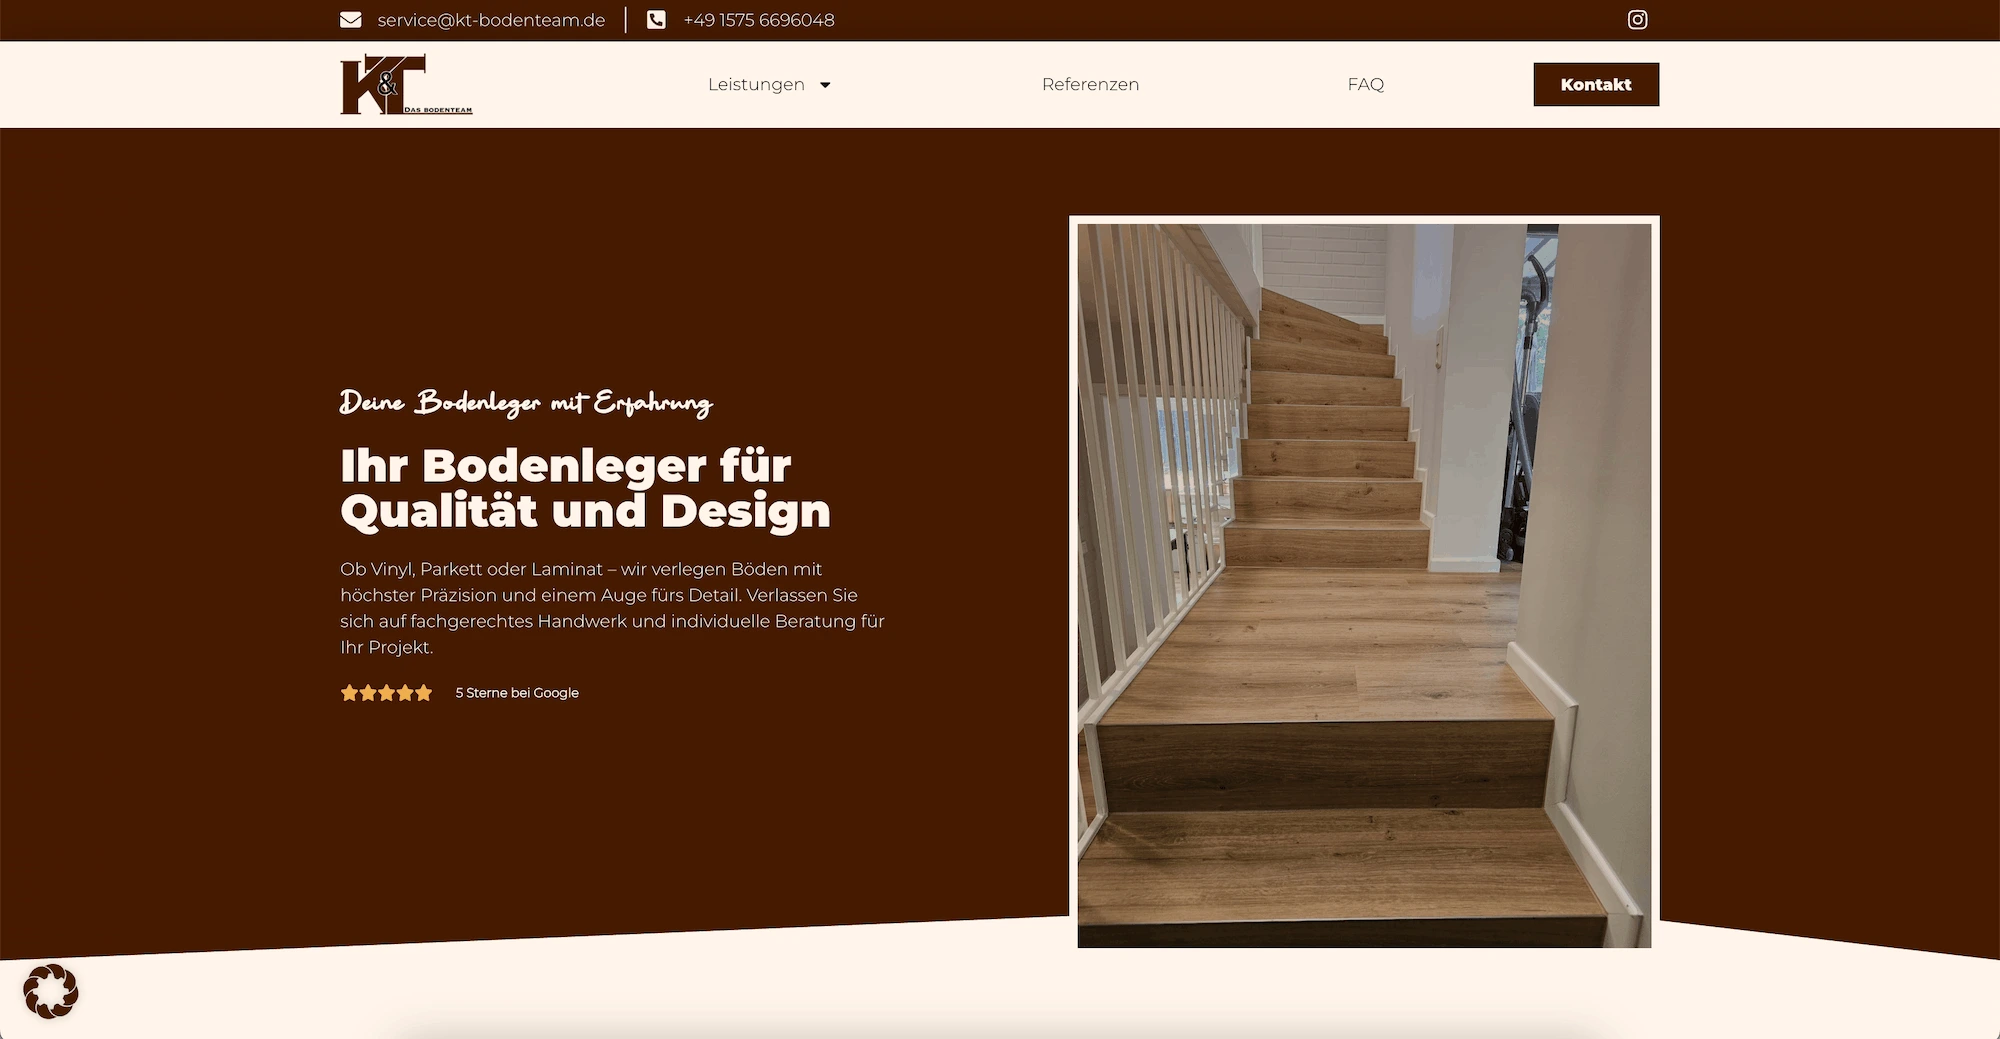
KT Bodenteam
Professioneller Auftritt für einen Bodenleger — Vorher-Nachher-Slider und regionale SEO.
Website ansehen ↗
Potassco Solutions
Klare Website für ein KI-Unternehmen, die komplexe Technologie verständlich macht.
Website ansehen ↗FAQ — Indexierung.
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling ist, ob die Seite abgerufen wird. Indexierung ist, ob sie aufgenommen wird. Beides kann einzeln scheitern — der häufigste Problemfall ist abgerufen und trotzdem nicht aufgenommen.
Was prüfe ich zuerst?
Die robots.txt und in WordPress den Schalter zur Suchmaschinensichtbarkeit in den Leseeinstellungen. Der ist der häufigste Einzelfall überhaupt — gesetzt beim Aufsetzen und nie wieder angefasst.
Was bedeutet „Gecrawlt, zurzeit nicht indexiert“?
Die Seite wurde abgerufen und bewusst nicht aufgenommen. Das ist keine technische Einstellung, sondern ein Urteil über den Inhalt — meist zu wenig Eigenes.
Warum bleibt eine Seite im Index, obwohl sie auf noindex steht?
Weil sie gleichzeitig in der robots.txt gesperrt ist. Dann darf die Suchmaschine sie nicht abrufen und sieht das noindex nie. Wer etwas aus dem Index entfernen will, muss es abrufbar lassen.
Reicht es, eine Seite in die Sitemap einzutragen?
Nein. Die Sitemap ist ein Hinweis, keine Garantie. Eine Seite, die von nirgendwo verlinkt ist, wird selten abgerufen — interne Verlinkung ist wichtiger.
Wie lange dauert es nach einer Korrektur?
Einige Tage bis mehrere Wochen, bei großen Websites länger. Eine einzelne wichtige Seite lässt sich über die Search Console zur erneuten Prüfung anmelden. Eine Änderung, dann warten, dann prüfen.
 Das bin ich – rechts im Bild
Erzähl mir, welche Seiten nicht gefunden werden.
Schick mir die Adresse und was dir auffällt — Seiten verschwinden aus dem Index, Besucher brechen weg, oder du weißt nach einem Relaunch nicht, was kaputtgegangen ist. Ich sehe nach, woran es liegt.
Antwort meist innerhalb von 24 Stunden · hallo@manuelkillert.de