Was wird tatsächlich abgerufen — und was nicht?
Die Serverprotokolle sind die einzige Quelle, die zeigt, was Suchmaschinen wirklich tun. Nicht, was sie tun sollten oder laut Bericht getan haben — sondern jeder einzelne Abruf mit Zeitpunkt, Adresse und Antwort.
Das Abrufbudget ist für die meisten Websites kein Thema — unter ein paar tausend Seiten reicht es immer. Relevant wird es bei großen Websites, Shops mit vielen Filtern und automatisch erzeugten Seiten. Die Protokolle zeigen dann, wo es hingeht: oft in Filterkombinationen, Weiterleitungsketten und Fehlerseiten statt in echte Inhalte.
Website down oder gehackt? Schreib mir per WhatsApp oder E-Mail mit Domain und kurzer Beschreibung — ich melde mich in der Regel innerhalb weniger Stunden, auch am Wochenende, wenn es brennt. Zugangsdaten bitte nie in der ersten Nachricht, sondern erst nach Absprache über einen sicheren Weg.
Das Abrufbudget.
Suchmaschinen rufen nicht beliebig viel ab. Wie viel, hängt von zwei Dingen ab: was der Server verträgt, und wie interessant die Website eingeschätzt wird. Eine schnelle, häufig aktualisierte Website wird öfter besucht als eine langsame, statische.
Das Wort Budget führt dabei in die Irre — es gibt keine feste Zahl, die man ausgibt. Treffender ist: Die Suchmaschine investiert Aufwand nach eigenem Ermessen, und du kannst beeinflussen, wofür dieser Aufwand draufgeht.
Wann es relevant wird.
| Lage | Relevanz |
|---|---|
| Unter 1.000 Seiten | Kein Thema |
| 1.000 bis 10.000 Seiten | Nur bei Auffälligkeiten |
| Über 10.000 Seiten | Relevant |
| Shop mit vielen Filtern | Relevant, unabhängig von der Seitenzahl |
| Automatisch erzeugte Seiten | Relevant |
| Langsamer Server | Relevant, weil weniger abgerufen wird |
| Häufige Inhaltsänderungen | Relevant, weil Aktualität zählt |
Zeile vier ist der häufigste Fall: Ein Shop mit fünfhundert Produkten hat über Filter und Sortierungen schnell fünfzigtausend erreichbare Adressen. Dann werden Kombinationen abgerufen statt neuer Produkte (Filteradressen).
Zeile sechs wird unterschätzt: Je langsamer der Server antwortet, desto vorsichtiger wird abgerufen. Tempoarbeit wirkt also auch hier (Serverantwortzeit).
Protokolle besorgen.
Jeder Webserver schreibt mit, wer wann was abgerufen hat. Bei den meisten Hostern gibt es diese Dateien im Kundenbereich, oft als gepackte Tagesdateien, meist für die letzten Wochen oder Monate.
Wenn du sie nicht findest: beim Support anfragen. Manche Anbieter schalten sie nur auf Anfrage frei, und manche löschen sie nach wenigen Tagen — dann lohnt es, die Aufbewahrung zu verlängern, bevor man sie braucht.
Datenschutz dabei beachten: Die Dateien enthalten Besucheradressen und sind personenbezogen. Für die Auswertung braucht es nur die Bot-Zugriffe; alles andere kann gefiltert und sollte nicht länger als nötig aufbewahrt werden (DSGVO).
Was drinsteht.
Je Zeile ein Abruf mit Zeitpunkt, aufgerufener Adresse, Antwortstatus, übertragener Größe und der Kennung des abrufenden Programms. Daraus lassen sich die interessanten Fragen beantworten:
- Welche Adressen werden am häufigsten abgerufen?
- Welche wichtigen Seiten werden selten oder nie abgerufen?
- Wie verteilen sich die Antwortstatus — wie viele Fehler?
- Wie viel Aufwand geht in Weiterleitungen?
- Werden Bereiche abgerufen, die gesperrt sein sollten?
- Wie oft kommt welcher Bot?
Für die Auswertung braucht es kein teures Werkzeug. Mit Bordmitteln auf der Kommandozeile lassen sich die Dateien filtern und zählen; für größere Mengen gibt es Tabellenkalkulationen und spezialisierte Programme.
Echte und gefälschte Bots.
Jedes Programm kann behaupten, eine Suchmaschine zu sein — und viele tun das, um Sperren zu umgehen. Wer die Protokolle nach der Kennung filtert, zählt also auch Fälschungen mit.
Prüfen lässt sich das über eine Rückwärtsauflösung der abrufenden Adresse: Gehört sie tatsächlich zum angegebenen Anbieter? Die großen Suchmaschinen veröffentlichen außerdem Listen ihrer Adressbereiche.
In der Praxis genügt eine Stichprobe. Fällt dabei auf, dass ein erheblicher Teil der angeblichen Suchmaschinenzugriffe gefälscht ist, hast du nebenbei ein Sicherheitsthema gefunden (Absichern).
Typische Funde.
| Fund | Bedeutung |
|---|---|
| Viele Abrufe auf Filterkombinationen | Aufwand geht ins Leere |
| Viele Weiterleitungen | Ketten auflösen, interne Links korrigieren |
| Viele Fehlerseiten | Tote Links, oft aus alten Beständen |
| Wichtige Seiten selten abgerufen | Verlinkung verbessern |
| Abrufe auf gesperrte Bereiche | Regeln prüfen |
| Alte Adressen werden weiter abgerufen | Externe Links, Weiterleitung sinnvoll |
| Einzelne Bots erzeugen hohe Last | Begrenzen erwägen |
Zeile sechs ist ein praktischer Nebengewinn: Die Protokolle zeigen Adressen, die von außen verlinkt sind und ins Leere laufen. Jede davon ist ein verlorener Besucher und eine verlorene Verlinkung — und eine Weiterleitung ist in zwei Minuten eingerichtet (Weiterleitungen).
Zeile vier ist der wichtigste Befund bei großen Websites: Wenn die Hälfte der Produktseiten in drei Monaten nie abgerufen wurde, ist das kein Zufall, sondern eine Folge der internen Verlinkung.
Crawling steuern.
- Unnötige Adressen gar nicht erzeugen — das wirksamste Mittel.
- Nicht verlinken, was nicht abgerufen werden soll.
- In der robots.txt sperren, was massenhaft entsteht (robots.txt).
- Canonical setzen bei Varianten, die erreichbar bleiben sollen.
- Weiterleitungsketten auflösen.
- Tote Links beseitigen.
- Serverantwortzeit verbessern — schnellere Server werden öfter besucht.
- Sitemap sauber halten (Sitemap).
Punkt eins und zwei stehen bewusst vorn. Eine Adresse, die nie entsteht, muss nicht gesperrt werden — und Sperren ist immer die schlechtere Lösung, weil sie nachträglich repariert, was man hätte vermeiden können.
Der Bericht in der Search Console.
Wer keine Protokolle bekommt, hat dort eine abgespeckte Alternative: Zahl der Abrufe je Tag, durchschnittliche Antwortzeit, Verteilung nach Antwortstatus und Dateityp, dazu eine Aufteilung nach Zweck.
Das reicht für eine grobe Einschätzung. Was fehlt, ist die Zuordnung zu einzelnen Adressen — man sieht, dass viele Fehler auftreten, aber nur eine Stichprobe davon, welche.
Worauf dort zu achten ist: ein plötzlicher Einbruch der Abrufe, ein Anstieg der Antwortzeit, oder ein wachsender Anteil von Fehlerstatus. Alle drei sind Warnzeichen, denen man nachgehen sollte.
Vorgehen.
- Protokolle der letzten vier Wochen besorgen.
- Auf Suchmaschinen-Bots filtern und Stichprobe auf Echtheit prüfen.
- Nach Antwortstatus auswerten — wie viel geht in Fehler und Weiterleitungen?
- Häufigste abgerufene Adressen ansehen: Sind das die wichtigen?
- Gegen die Sitemap halten: Welche wichtigen Seiten fehlen?
- Die drei größten Verschwender abstellen.
- Nach vier Wochen erneut messen.
Schritt sechs ist die eigentliche Arbeit. In der Regel findet man zwei oder drei Muster, die den Großteil ausmachen — und wenn die weg sind, verschiebt sich der Aufwand sichtbar auf echte Inhalte.
Wann es sich lohnt.
Ehrlich: für die meisten Websites nicht. Bei einer Unternehmenswebsite mit zweihundert Seiten gibt es nichts zu optimieren — alles wird ohnehin abgerufen, und die Zeit ist in Inhalten besser angelegt.
Lohnend wird es bei großen Websites, bei Shops mit vielen Filtern, bei automatisch erzeugten Seiten, nach einem Relaunch mit vielen Adressänderungen und wenn in der Search Console auffällt, dass neue Inhalte nur schleppend erfasst werden.
Wenn du unsicher bist: Der Bericht in der Search Console ist kostenlos und in fünf Minuten angesehen. Wenn dort nichts auffällt, brauchst du keine Protokollauswertung.
Wenn du nicht weiterkommst.
Wenn neue Inhalte nur schleppend erfasst werden oder du wissen willst, wofür der Aufwand draufgeht. Ich prüfe, was tatsächlich im Weg steht, und behebe es: technisches SEO. Geht es um Tempo, hängt das mit dran (Core Web Vitals). Damit es so bleibt, gehört die regelmäßige Kontrolle in die laufende Betreuung.
Ursache finden, Website wieder zum Laufen bringen, kurzer Bericht — meist am selben Tag.
Für Anpassungen, Fehlerbehebung und Beratung nach Aufwand, abgerechnet in 15-Minuten-Schritten.
Updates, Backups, Sicherheitscheck, Monitoring — Kleinigkeiten inklusive.
Orientierungswerte, keine Fixpreise — nach einem kurzen Gespräch bekommst du ein Festpreisangebot.
Wer hilft.
Ich bin Manuel Killert, Webentwickler aus Quakenbrück. Technisches SEO ist bei mir kein Marketingangebot, sondern die Fortsetzung der Entwicklungsarbeit: ordentliche Adressen, saubere Weiterleitungen, korrekte Auszeichnungen, erreichbare Inhalte. Das sind Dinge, die man im Quelltext prüft und behebt — nicht in einem Konzept beschreibt.
Was ich nicht mache: Inhaltsstrategie, Keyword-Recherche als Dauerleistung, Linkaufbau oder monatliche Berichte mit grünen Pfeilen. Dafür gibt es Leute, die das besser können. Wenn dein Problem heißt „wir brauchen mehr Themen“, bist du bei einer SEO-Agentur richtig; wenn es heißt „unsere Seiten sind nicht im Index“, bei mir.
Und ich verspreche keine Platzierungen. Wer dir Platz eins garantiert, weiß entweder nicht, wovon er redet, oder meint ein Keyword, nach dem niemand sucht.
Echte Projekte — live ansehen.
WordPress-Websites, die ich gebaut habe oder laufend betreue.
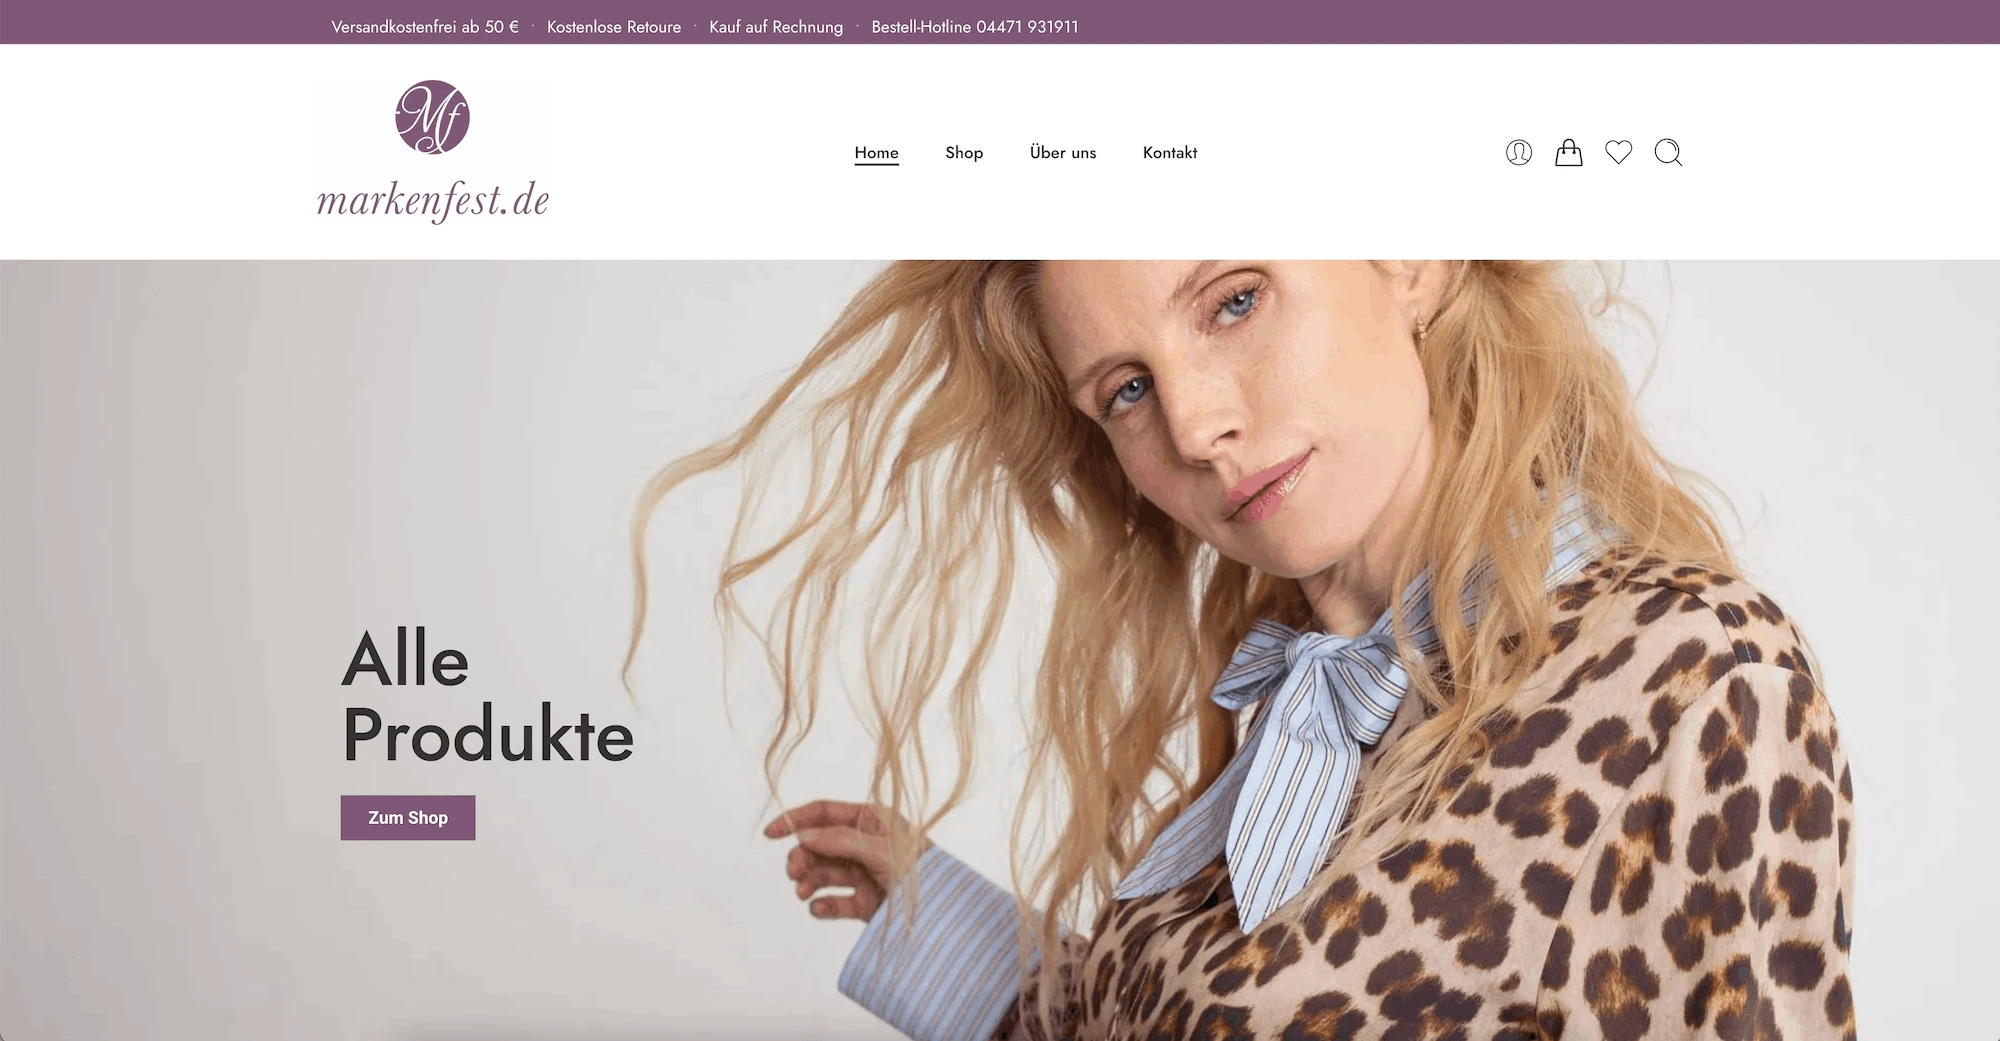
Markenfest
Stärkerer Online-Shop — Webdesign, Content und individuelle Shop-Funktionen.
Website ansehen ↗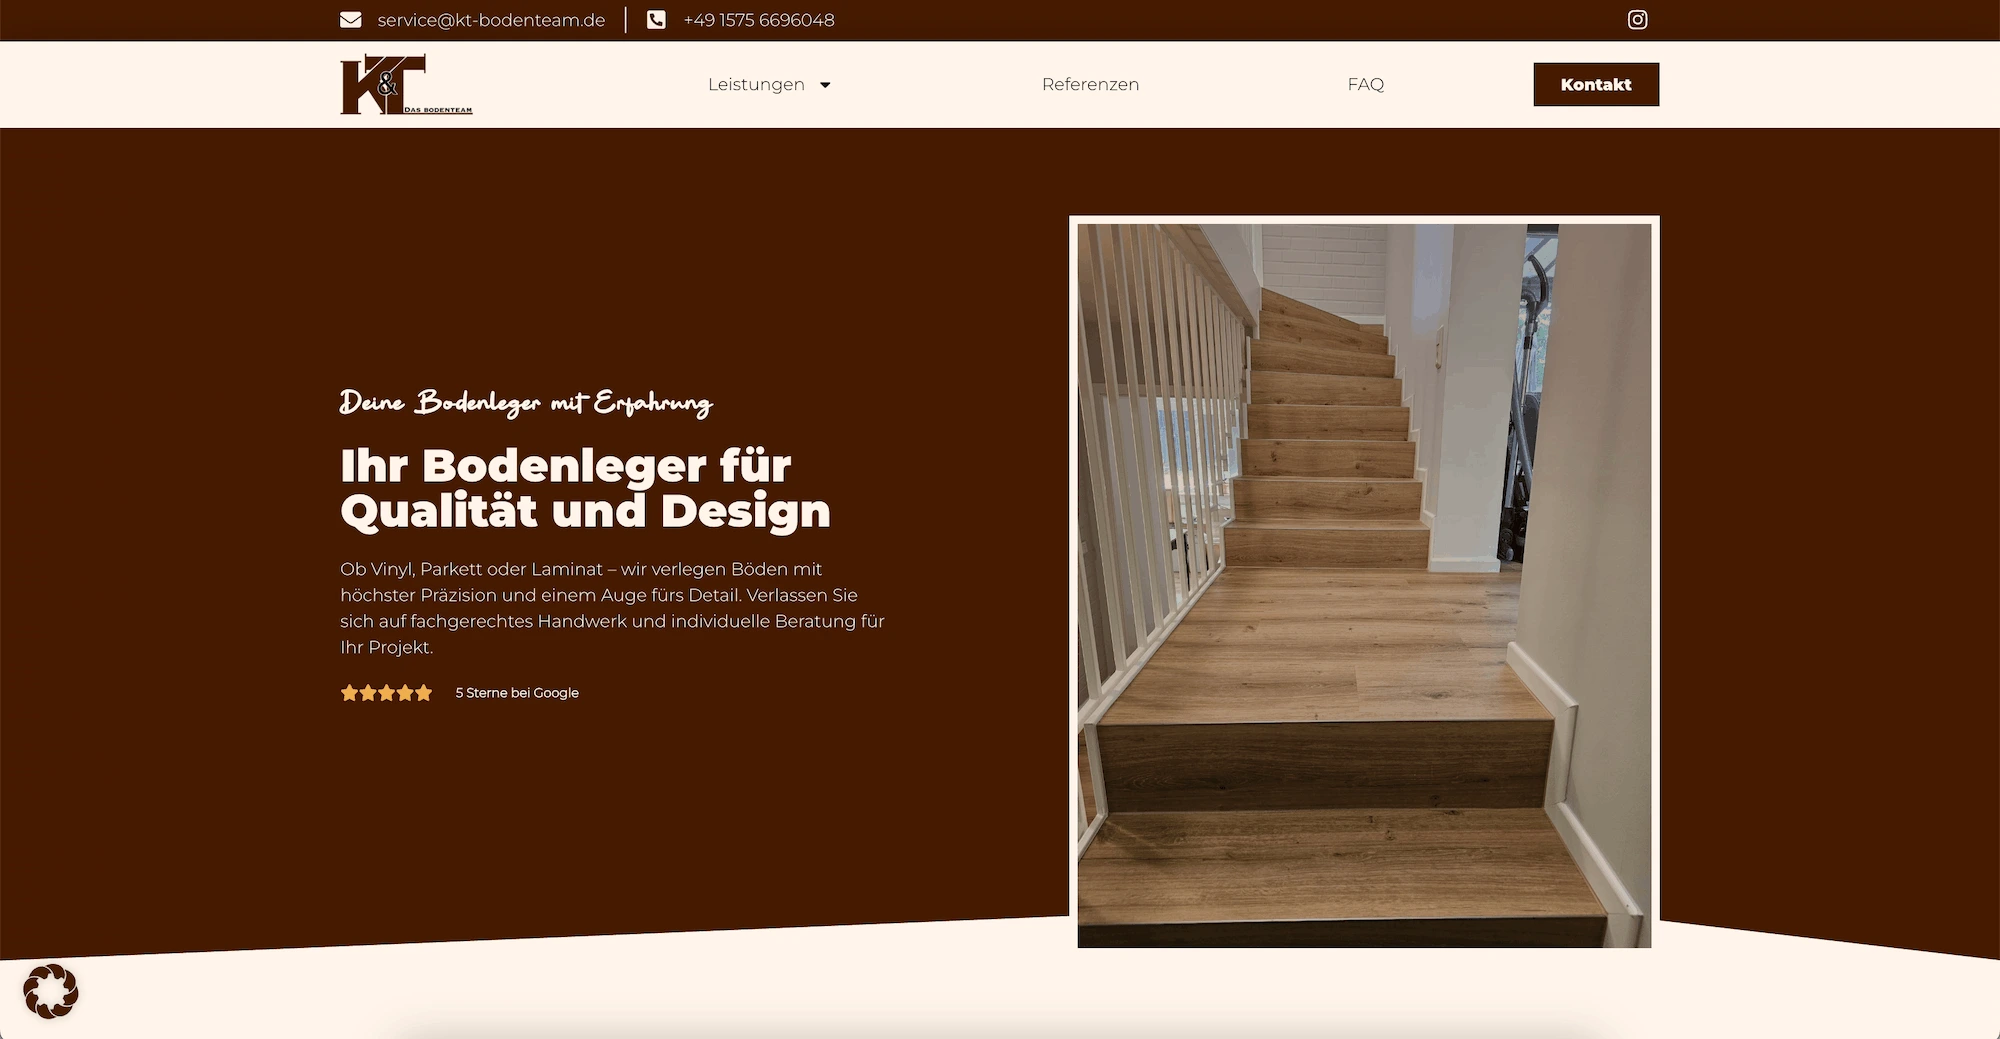
KT Bodenteam
Professioneller Auftritt für einen Bodenleger — Vorher-Nachher-Slider und regionale SEO.
Website ansehen ↗
Potassco Solutions
Klare Website für ein KI-Unternehmen, die komplexe Technologie verständlich macht.
Website ansehen ↗FAQ — Crawling & Protokolle.
Was ist das Crawling-Budget?
Kein festes Kontingent, sondern der Aufwand, den eine Suchmaschine in deine Website investiert — abhängig davon, was der Server verträgt und wie interessant die Website eingeschätzt wird.
Ist das für meine Website relevant?
Unter tausend Seiten praktisch nie. Relevant wird es bei großen Websites, bei Shops mit vielen Filterkombinationen, bei automatisch erzeugten Seiten und bei langsamen Servern.
Woher bekomme ich die Serverprotokolle?
Meist im Kundenbereich des Hosters als gepackte Tagesdateien. Manche Anbieter schalten sie nur auf Anfrage frei oder löschen sie nach wenigen Tagen — dann die Aufbewahrung verlängern lassen.
Wie erkenne ich gefälschte Suchmaschinen-Bots?
Über eine Rückwärtsauflösung der abrufenden Adresse: Gehört sie wirklich zum angegebenen Anbieter? Die großen Suchmaschinen veröffentlichen außerdem ihre Adressbereiche.
Was findet man typischerweise?
Dass der Aufwand in Filterkombinationen, Weiterleitungsketten und Fehlerseiten geht statt in echte Inhalte — und dass wichtige Seiten selten abgerufen werden, weil die interne Verlinkung fehlt.
Was ist das wirksamste Mittel?
Unnötige Adressen gar nicht erst zu erzeugen und nicht zu verlinken. Sperren ist immer die schlechtere Lösung, weil sie nachträglich repariert, was vermeidbar gewesen wäre.
 Das bin ich – rechts im Bild
Erzähl mir, welche Seiten nicht gefunden werden.
Schick mir die Adresse und was dir auffällt — Seiten verschwinden aus dem Index, Besucher brechen weg, oder du weißt nach einem Relaunch nicht, was kaputtgegangen ist. Ich sehe nach, woran es liegt.
Antwort meist innerhalb von 24 Stunden · hallo@manuelkillert.de